Viele Organisationen haben inzwischen etwas vorzuweisen: einen Chat-Dienst für die Verwaltung, ein paar Proofs of Concept, vielleicht einen eigenen Server mit einem offenen Modell. Das ist Fortschritt. Nur beantwortet es nicht die Frage, die ein Vorstand, ein Fördermittelgeber oder die eigene Personalplanung stellt: Was kann diese Organisation mit KI dauerhaft leisten, und was fehlt ihr dafür?
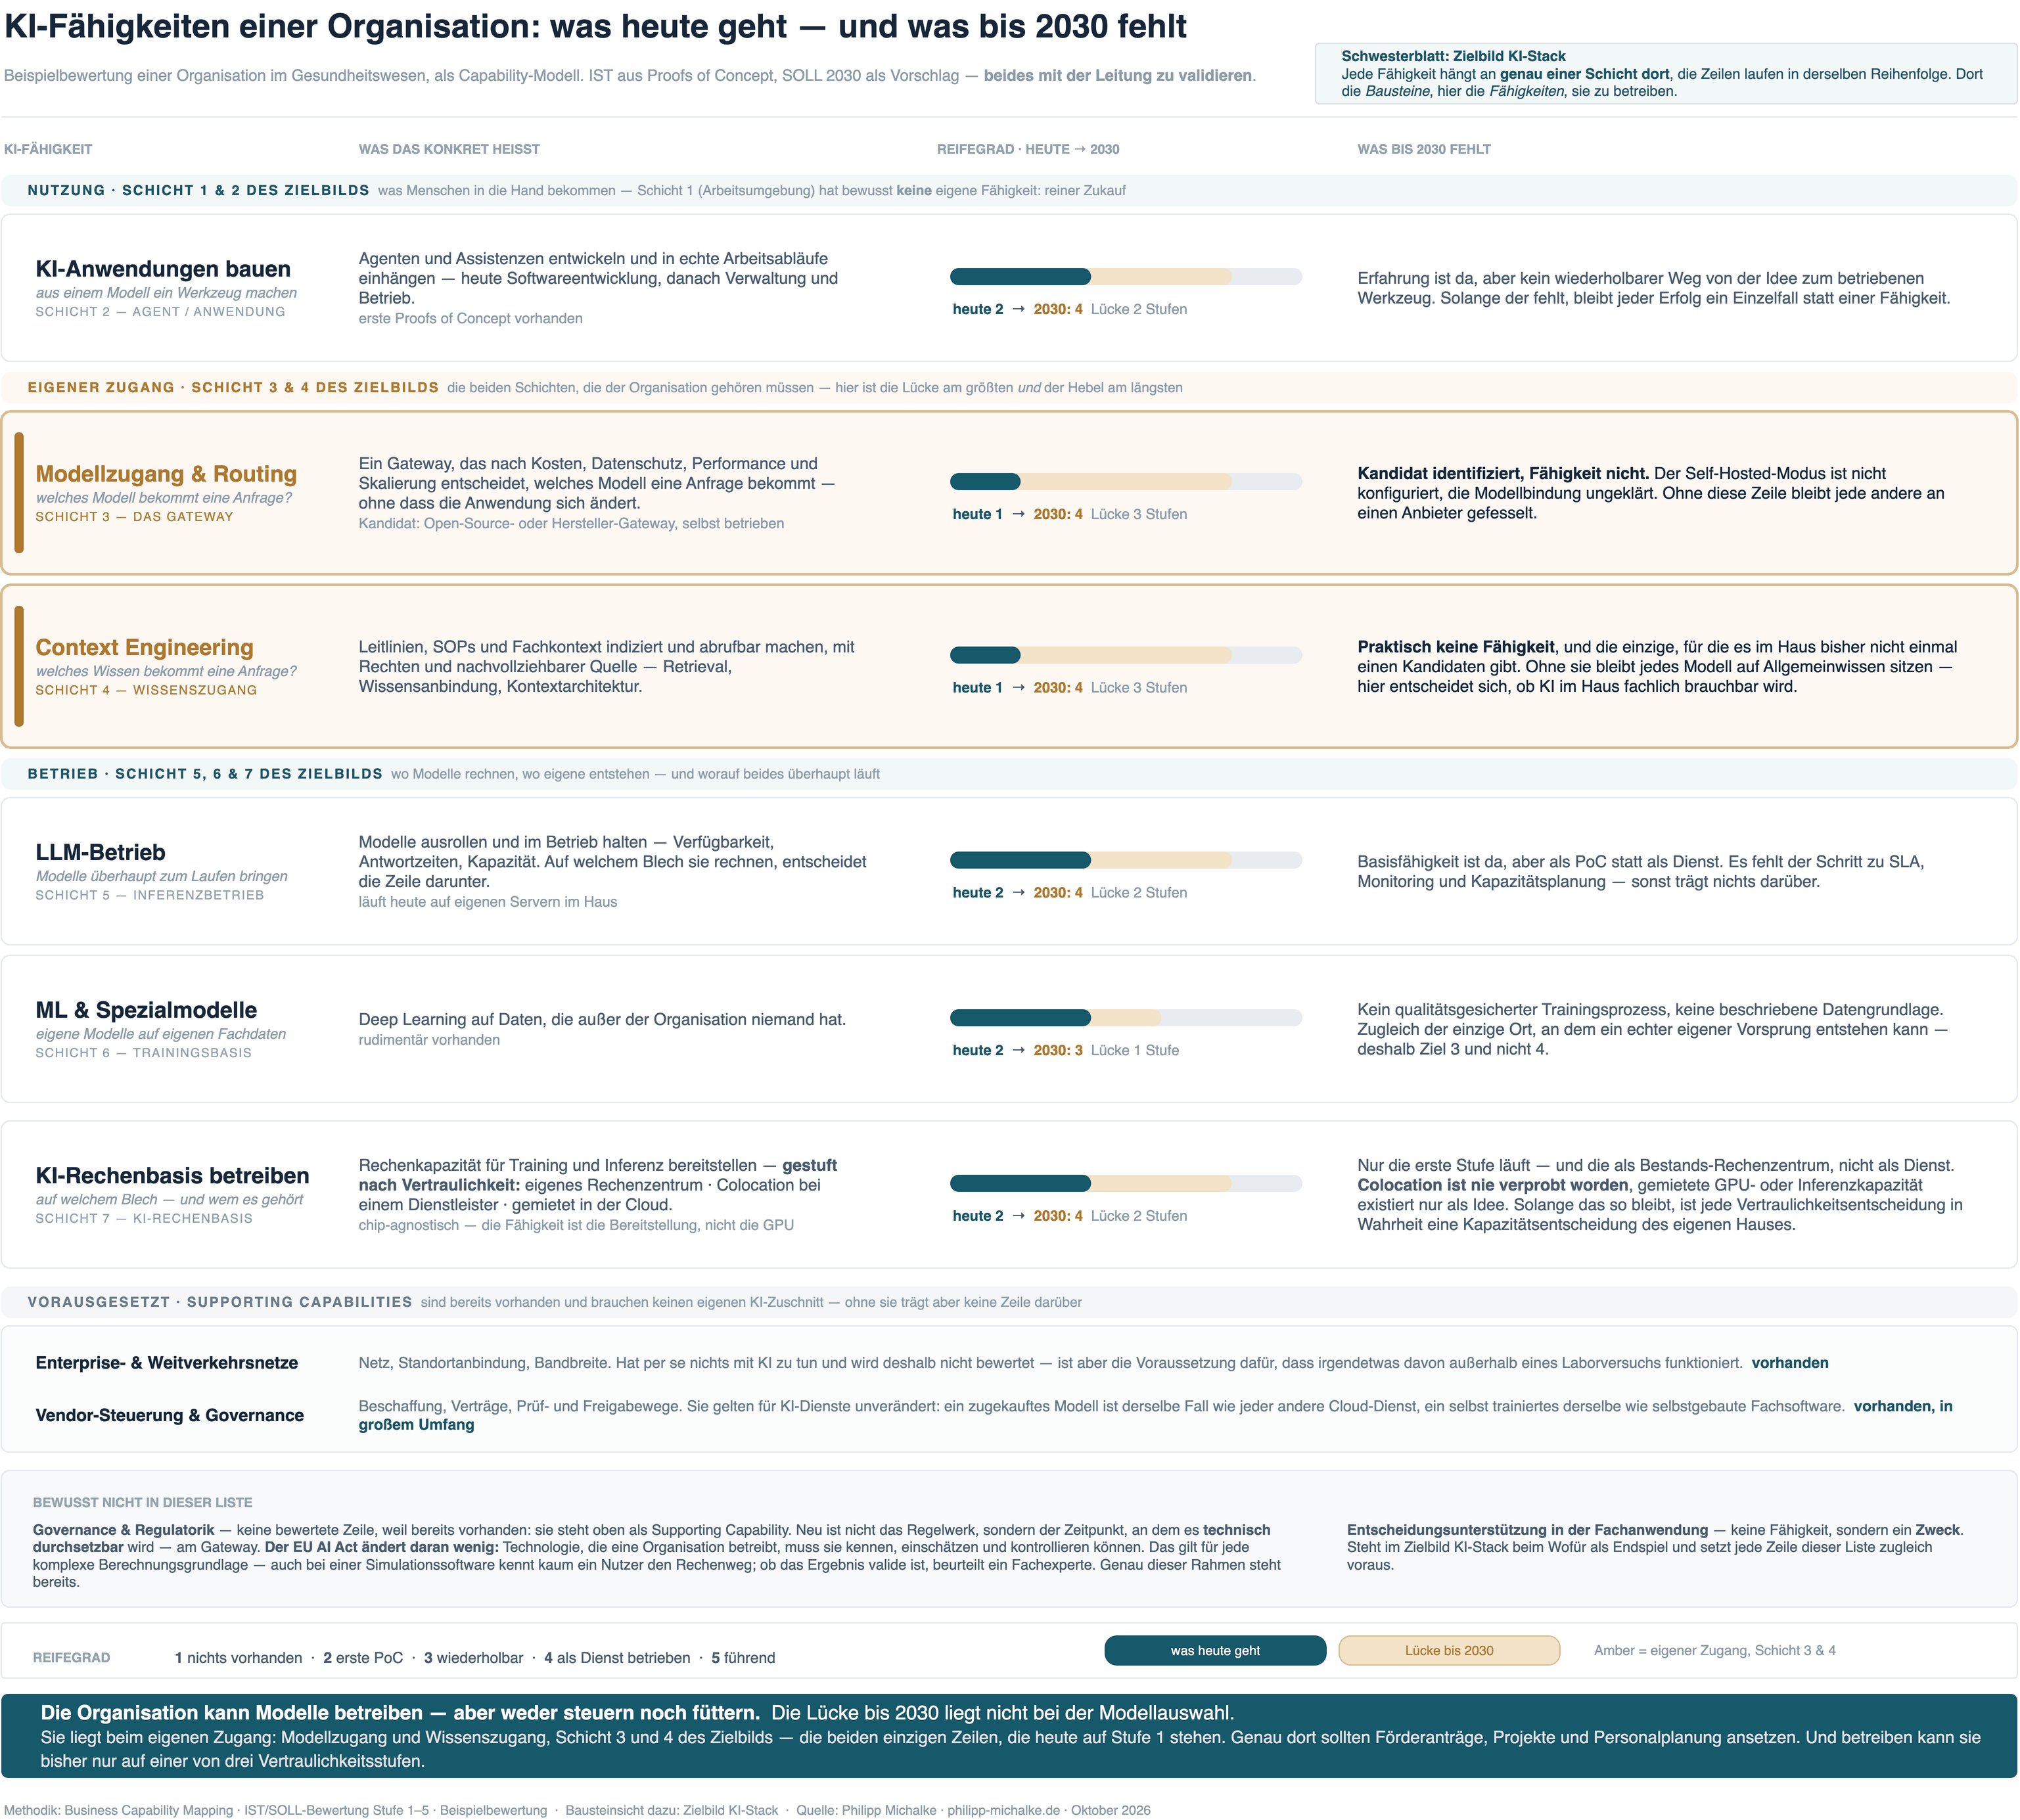
Meine These: Diese Frage beantwortet man nicht mit einer KI-Strategie im Ganzen, sondern mit einem Reifegrad je Fähigkeit. Man schneidet KI in wenige Fähigkeiten, bewertet jede auf einer Skala von 1 bis 5, heute und als Ziel, und schreibt in einem Satz auf, was dazwischen fehlt. Das Bild zeigt eine solche Bewertung als Beispiel für eine Organisation im Gesundheitswesen. Seine Kernaussage passt in einen Satz: Die Organisation kann Modelle betreiben, aber weder steuern noch füttern.
So lesen Sie das Bild
Das Bild ist eine Tabelle mit vier Spalten. Links steht die Fähigkeit, daneben in einem Satz, was sie konkret heißt. Die dritte Spalte zeigt den Reifegrad als Balken: dunkel, was heute da ist, hell, was bis 2030 dazukommen soll. Rechts steht, was bis dahin fehlt. Diese letzte Spalte ist die wichtigste. Die Zahlen sortieren, die Sätze erklären.
Die Skala hat fünf Stufen: 1 nichts vorhanden, 2 erste Proofs of Concept, 3 wiederholbar, 4 als Dienst betrieben, 5 führend. Der entscheidende Sprung liegt zwischen 2 und 4. Ein Proof of Concept beweist, dass etwas geht. Ein Dienst verspricht, dass es morgen wieder geht, mit Verfügbarkeit, Ansprechpartner und Kapazitätsplanung.
Die sechs Zeilen sind in drei Bänder gruppiert:
- Nutzung: KI-Anwendungen bauen, also Agenten und Assistenten entwickeln und in echte Arbeitsabläufe einhängen. Im Beispiel heute 2, Ziel 4.
- Eigener Zugang, farbig hervorgehoben: Modellzugang und Routing (welches Modell bekommt eine Anfrage?) und Context Engineering (welches Wissen bekommt sie?). Beide heute 1, Ziel 4. Das ist die größte Lücke im Bild.
- Betrieb: LLM-Betrieb (Modelle ausrollen und verfügbar halten, 2 nach 4), ML und Spezialmodelle (eigene Modelle auf eigenen Daten, 2 nach 3) und die KI-Rechenbasis (Rechenkapazität bereitstellen, 2 nach 4).
Darunter folgen vorausgesetzte, unbewertete Fähigkeiten und zwei Dinge, die bewusst fehlen. Dazu unten mehr.
Fähigkeiten bewerten, nicht Produkte
Die Methode stammt aus dem Enterprise Architecture Management und heißt Business Capability Mapping. Eine Fähigkeit beschreibt, was eine Organisation kann, unabhängig davon, womit. Das klingt nach Begriffsklauberei. Es ist der Kern der Sache.
Produkte wechseln bei KI im Halbjahrestakt. Fähigkeiten nicht. Wer seinen Stand an Produkten misst, zählt Lizenzen und weiß danach wenig. Wer ihn an Fähigkeiten misst, fragt: Was müsste geschehen, damit das zweite Fachteam dieselbe Leistung in einer Woche bekommt statt in einem halben Jahr? Ein Produkt ist in diesem Bild höchstens ein Kandidat. Man kann einen guten Kandidaten für die Vermittlungsstelle zu den Modellen gefunden haben und trotzdem auf Stufe 1 stehen, solange nichts davon eingerichtet und betrieben ist.
Jede Fähigkeit hängt an genau einer Schicht des KI-Stacks, wie ich ihn im Artikel „Nicht auf den Sieger wetten. Den Wechsel billig halten.“ beschrieben habe. Dort stehen die Bausteine, hier die Fähigkeiten, sie zu betreiben. Eine Schicht hat bewusst keine eigene Fähigkeit: die Arbeitsumgebung, also Editor, Chat-Oberfläche oder Office-Programm. Die kauft man. Wer hier eine Fähigkeit aufbaut, baut am falschen Ende.
Ein gefundener Kandidat ist noch keine Fähigkeit.
Die Lücke liegt beim Zugang, nicht beim Modell
Über Modelle wird am meisten gesprochen: welches besser ist, welches billiger, welches im eigenen Haus laufen darf. In der Beispielbewertung ist das die kleinere Frage. Modelle betreiben kann die Organisation schon auf Stufe 2. Die beiden Zeilen auf Stufe 1 liegen dazwischen, an der Stelle, an der Anwendungen auf Modelle und Wissen treffen.
Modellzugang und Routing heißt: Jede Anfrage läuft über eine eigene Vermittlungsstelle, ein Gateway, das nach Kosten, Datenschutz, Leistung und Last entscheidet, welches Modell sie bekommt. Die Anwendung merkt davon nichts. Fehlt diese Stelle, bleibt jede Anwendung an das Modell gebunden, mit dem sie gebaut wurde. Dann wird jeder Anbieterwechsel ein Umbau, und jede Datenschutzregel steht auf Papier statt in der Konfiguration.
Context Engineering heißt: Das eigene Wissen ist für Modelle abrufbar. Leitlinien, Arbeitsanweisungen und Fachdokumente, indiziert, mit Rechten versehen und mit nachvollziehbarer Quelle. Das ist etwas anderes als Training. Ein trainiertes Modell weiß, was in seinen Trainingsdaten stand. Ein Agent, der die gültige Fassung einer Arbeitsanweisung braucht, muss sie zur Laufzeit finden, und er darf nur finden, was sein Nutzer sehen darf. Ohne diese Fähigkeit bleibt jedes Modell, so gut es sein mag, auf Allgemeinwissen sitzen. Hier entscheidet sich, ob KI fachlich brauchbar wird.
Warum fallen ausgerechnet diese beiden Zeilen zurück? Ich vermute einen strukturellen Grund. Ein Proof of Concept beginnt mit einem laufenden Modell; das ist der sichtbare Erfolg. Ein Gateway lohnt sich erst ab der zweiten Anwendung, ein Wissenszugang erst ab der ersten echten Dokumentenquelle mit Berechtigungen. Beides gehört keinem Projekt allein, und deshalb baut es keines.
Daraus folgt eine Empfehlung für die Planung: Förderanträge, Projekte und Stellen gehören zuerst an diese beiden Zeilen. Nicht weil Modelle unwichtig wären, sondern weil jede andere Zeile auf ihnen aufsetzt. Was hier investiert wird, wirkt auf alle Anwendungen darüber.
Modelle kann man kaufen. Den Zugang zum eigenen Wissen nicht.
Betrieb, gestuft nach Vertraulichkeit
Im Betriebsband stecken zwei Schnitte, die man leicht übersieht.
Der erste trennt den LLM-Betrieb von der KI-Rechenbasis. Modelle ausrollen und im Betrieb halten, mit Verfügbarkeit, Antwortzeiten und Kapazität, ist eine Fähigkeit. Die Maschinen bereitzustellen, auf denen sie rechnen, ist eine andere. Wer beides in eine Zeile packt, bewertet am Ende einen Durchschnitt, der niemandem hilft. Die Rechenbasis ist dabei bewusst unabhängig vom Chip formuliert. Die Fähigkeit ist die Bereitstellung, nicht das Bauteil: Heute sind es Grafikprozessoren, morgen vielleicht andere Beschleuniger.
Der zweite Schnitt stuft die Rechenbasis nach Vertraulichkeit: eigenes Rechenzentrum, dedizierte Umgebung bei einem Dienstleister, gemietete Kapazität in der Cloud. Im Beispiel läuft nur die erste Stufe, und die als Bestand, nicht als bestellbarer Dienst. Das klingt nach einer Fußnote, hat aber eine unangenehme Folge: Solange nur eine Stufe verfügbar ist, ist jede Vertraulichkeitsentscheidung in Wahrheit eine Kapazitätsentscheidung. Man fragt dann nicht mehr, wo die Daten rechnen dürfen, sondern wo gerade Platz ist.
Bleibt die Zeile ML und Spezialmodelle: eigene Modelle, etwa auf Bild- oder Labordaten, die außer der Organisation niemand hat. Ihr Ziel liegt bewusst bei 3, nicht bei 4. Ein wiederholbarer, qualitätsgesicherter Trainingsweg reicht; ein Dienst mit Betriebszusage wäre hier zu viel. Trotzdem ist es die einzige Zeile, an der ein echter eigener Vorsprung entstehen kann. Alles andere können andere Häuser genauso kaufen.
Was bewusst nicht bewertet wird
Ein Fähigkeitsmodell sagt durch seine Grenzen so viel wie durch seine Zeilen.
Unter den bewerteten Zeilen steht ein Band mit vorausgesetzten Fähigkeiten, im Fachjargon Supporting Capabilities: Netze und Standortanbindung, dazu Vendor-Steuerung und Governance, also Beschaffung, Verträge, Prüf- und Freigabewege. Sie bekommen keinen Balken, weil sie keinen eigenen KI-Zuschnitt brauchen. Ein zugekauftes Modell ist vertraglich derselbe Fall wie jeder andere Cloud-Dienst. Sie stehen trotzdem im Bild, damit niemand sie für vergessen hält. Ohne sie trägt keine Zeile darüber.
Deshalb ist auch Governance und Regulatorik keine eigene bewertete Zeile: weil sie vorhanden ist, nicht weil sie fehlt. Neu ist nicht das Regelwerk, sondern der Zeitpunkt, ab dem es technisch durchsetzbar wird. Sobald ein Gateway steht, wird die Regel „welche Daten zu welchem Modell“ zur Einstellung im System. Meine Haltung zur europäischen KI-Verordnung folgt derselben Logik: Technologie, die man betreibt, muss man kennen, einschätzen und kontrollieren können. Das gilt seit jeher für jede komplexe Berechnungsgrundlage. Auch bei einer Simulationssoftware kennt kaum ein Nutzer den Rechenweg; ob das Ergebnis valide ist, beurteilt der Fachexperte. Die Verordnung bringt allerdings eigene Pflichten mit, etwa für Betreiber von Hochrisiko-Systemen, und sie wirft die Frage auf, ab wann eine Organisation durch eine wesentliche Änderung an einem System selbst als Anbieter gilt. Das verschiebt Zeitpunkte und Nachweise. Die Liste der Fähigkeiten verschiebt es nicht.
Bewusst ausgelassen ist auch die Entscheidungsunterstützung in der Fachanwendung, im Gesundheitswesen etwa bei der Diagnose. Sie ist keine Fähigkeit, sondern ein Zweck. Sie setzt jede Zeile der Liste voraus und gehört deshalb nicht hinein. Wer einen Zweck als Fähigkeit führt, bewertet ein Ziel mit einer Zahl und versteckt dahinter alle Voraussetzungen. In anderen Branchen heißt dieser Zweck vielleicht Prozessautomatisierung oder Kundenservice; die Regel gilt genauso.
Die stärkste Gegenposition
Gegen all das gibt es einen ernsten Einwand, und er verdient seine beste Form. Reifegradmodelle, so das Argument, erzeugen Scheingenauigkeit. Eine 2 und eine 4 sehen aus wie Messwerte, sind aber Meinungen, ausgehandelt in einem Workshop, in dem der Ranghöchste die Zahl prägt und jeder sein eigenes Team ein wenig besser sieht. Ein Zielwert für 2030 ist in einem Markt, der sich im Halbjahrestakt dreht, Kaffeesatzleserei. Am Ende pflegt jemand ein Modell, das niemand liest. Besser wäre, drei konkrete Anwendungsfälle zu wählen und umzusetzen. Die Fähigkeiten entstünden dabei von selbst.
Dieser Einwand hat in wichtigen Punkten recht. Die Zahlen sind keine Messung. Sie sind ein Gesprächswerkzeug, und wer sie als Kennzahl ins Berichtswesen überträgt, macht aus einem guten Werkzeug ein schlechtes. Auch die Selbstbewertung ist anfällig. Abhilfe schafft, jede Stufe an einen beobachtbaren Beleg zu binden. Stufe 2 heißt: Es gibt einen Proof of Concept, den man zeigen kann. Stufe 4 heißt: Ein anderes Team kann den Dienst bestellen, und jemand steht für seine Verfügbarkeit gerade. Über Belege streitet man anders als über Gefühle.
Beim Zielwert 2030 trägt der Einwand weniger weit. Produkte für 2030 vorherzusagen wäre tatsächlich Kaffeesatzleserei. Fähigkeiten altern langsamer: Dass eine Organisation 2030 Anfragen steuern und eigenes Wissen anbinden können muss, gilt unabhängig davon, welche Modelle dann vorne liegen. Und die Fähigkeiten entstehen eben nicht von selbst. Drei Anwendungsfälle ohne gemeinsamen Zugang erzeugen drei Modellanbindungen, drei Wissensablagen und drei Verträge. Die Zeilen, die allen gehören, baut kein einzelnes Projekt.
Was nicht trägt, ist eine Bewertung ohne Folgen. Ein Fähigkeitsmodell lohnt sich nur, wenn danach Geld, Projekte und Stellen anders verteilt werden als vorher.
Fünf Fragen für die eigene Bewertung
Wer den eigenen Stand so bewerten will, kommt mit einem halben Tag und fünf Fragen weit.
Entscheidungshilfe
Das Ergebnis passt auf eine Seite. Bewerten Sie es einmal im Jahr neu, mit denselben Belegfragen.
Steuern und füttern
Die meisten Gespräche über KI drehen sich um Modelle, weil sie sichtbar und vergleichbar sind. Die Bewertung je Fähigkeit lenkt den Blick auf das, was darunter und dazwischen liegt. Eine Organisation, die Modelle betreiben kann, hat den leichten Teil geschafft. Den schweren hat sie vor sich: steuern, welches Modell was bekommt, und füttern, mit dem Wissen, das nur sie hat.
Die Frage, die ich deshalb zuerst stellen würde, lautet nicht: Welches Modell nutzen Sie? Sondern: Wenn morgen ein zweites Fachteam eine KI-Anwendung will, über welchen Weg bekommt es Modell und Wissen?